

Embeddings Model(嵌入模型):嵌入技术通过将文本、图像和视频转换为浮点数数组(称为向量)来实现。这些向量旨在捕捉文本、图像和视频的语义信息。嵌入数组的长度被称为向量的维度。
通过计算两段文本的向量表示之间的数值距离,应用程序可以确定用于生成嵌入向量的对象之间的相似性。这里通常可以用向量的余弦相似度来计算,结果越大越相似。
一、简单例子
1、配置嵌入模型
要在配置文件中指定,这里用的是openai的但是配置用的是千问的,他们兼容。
spring:application:name: spring-ai-testai:openai:api-key: ${AI_BAILIAN_API_KEY}base-url: https://dashscope.aliyuncs.com/compatible-mode/v1chat:model: qwen3.8-flashtemperature: 0.7embedding:model: qwen3.7-text-embedding-flashdimensions: 2048
2、余弦相似度工具类
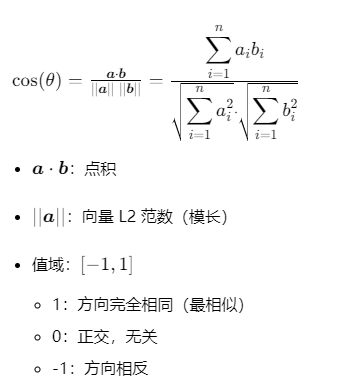
public class VectorSimilarityUtil {/*** 余弦相似度 cosine similarity* @param vecA embedding向量* @param vecB embedding向量* @return [-1,1],越接近1越相似*/public static float cosineSimilarity(float[] vecA, float[] vecB) {if (vecA == null || vecB == null || vecA.length != vecB.length) {throw new IllegalArgumentException("向量不能为空且维度必须一致");}float dot = 0f;float normA = 0f;float normB = 0f;for (int i = 0; i < vecA.length; i++) {dot += vecA[i] * vecB[i];normA += vecA[i] * vecA[i];normB += vecB[i] * vecB[i];}if (normA == 0 || normB == 0) {return 0f;}return dot / ( (float) Math.sqrt(normA) * (float) Math.sqrt(normB) );}}
3、简单例子
@RestControllerpublic class TestController {@Autowiredprivate OpenAiEmbeddingModel embeddingModel;@GetMapping("/em")public String em(){float[] results1 = embeddingModel.embed(new Document("我爱java"));float[] results2 = embeddingModel.embed(new Document("我爱php"));float[] results3 = embeddingModel.embed(new Document("我爱小猫咪"));float a = VectorSimilarityUtil.cosineSimilarity(results1,results2);float b = VectorSimilarityUtil.cosineSimilarity(results1,results3);//越大越像System.out.println("我爱java和我爱php的余弦相似度:"+a);System.out.println("我爱java和我爱小猫咪的余弦相似度:"+b);//我爱java和我爱php的余弦相似度:0.69244385// 我爱java和我爱小猫咪的余弦相似度:0.644336return "ok";}}
嵌入向量返回的是一个2048维度的数组,根据上面的输出结果可以知道,我爱java和我爱php是比较相似的。
二、为啥要用嵌入模型
嵌入模型就是把文本转成定长向量,让计算机可以用余弦相似度判断语义是否相近。解决了传统关键词检索(如Elasticsearch)无法理解语义关联的问题(例如查询“治疗感冒的药”,可匹配“缓解伤风症状的药物”这类语义相似但关键词不同的文档),是RAG系统中“检索”环节的核心支撑。
